9月16日に出たIonQ・オークリッジ国立研究所・NVIDIA・テネシー大学の共同研究が短くしたのは、量子ビットの数ではなく時間でした。256に届いた、1万を目指す、という数の話とは別の場所です。
詰まっていたのは、解くための回路を1本見つけるのにかかる時間です。
・IonQ・オークリッジ国立研究所(ORNL)・NVIDIA・テネシー大の共同研究。主導は ORNL
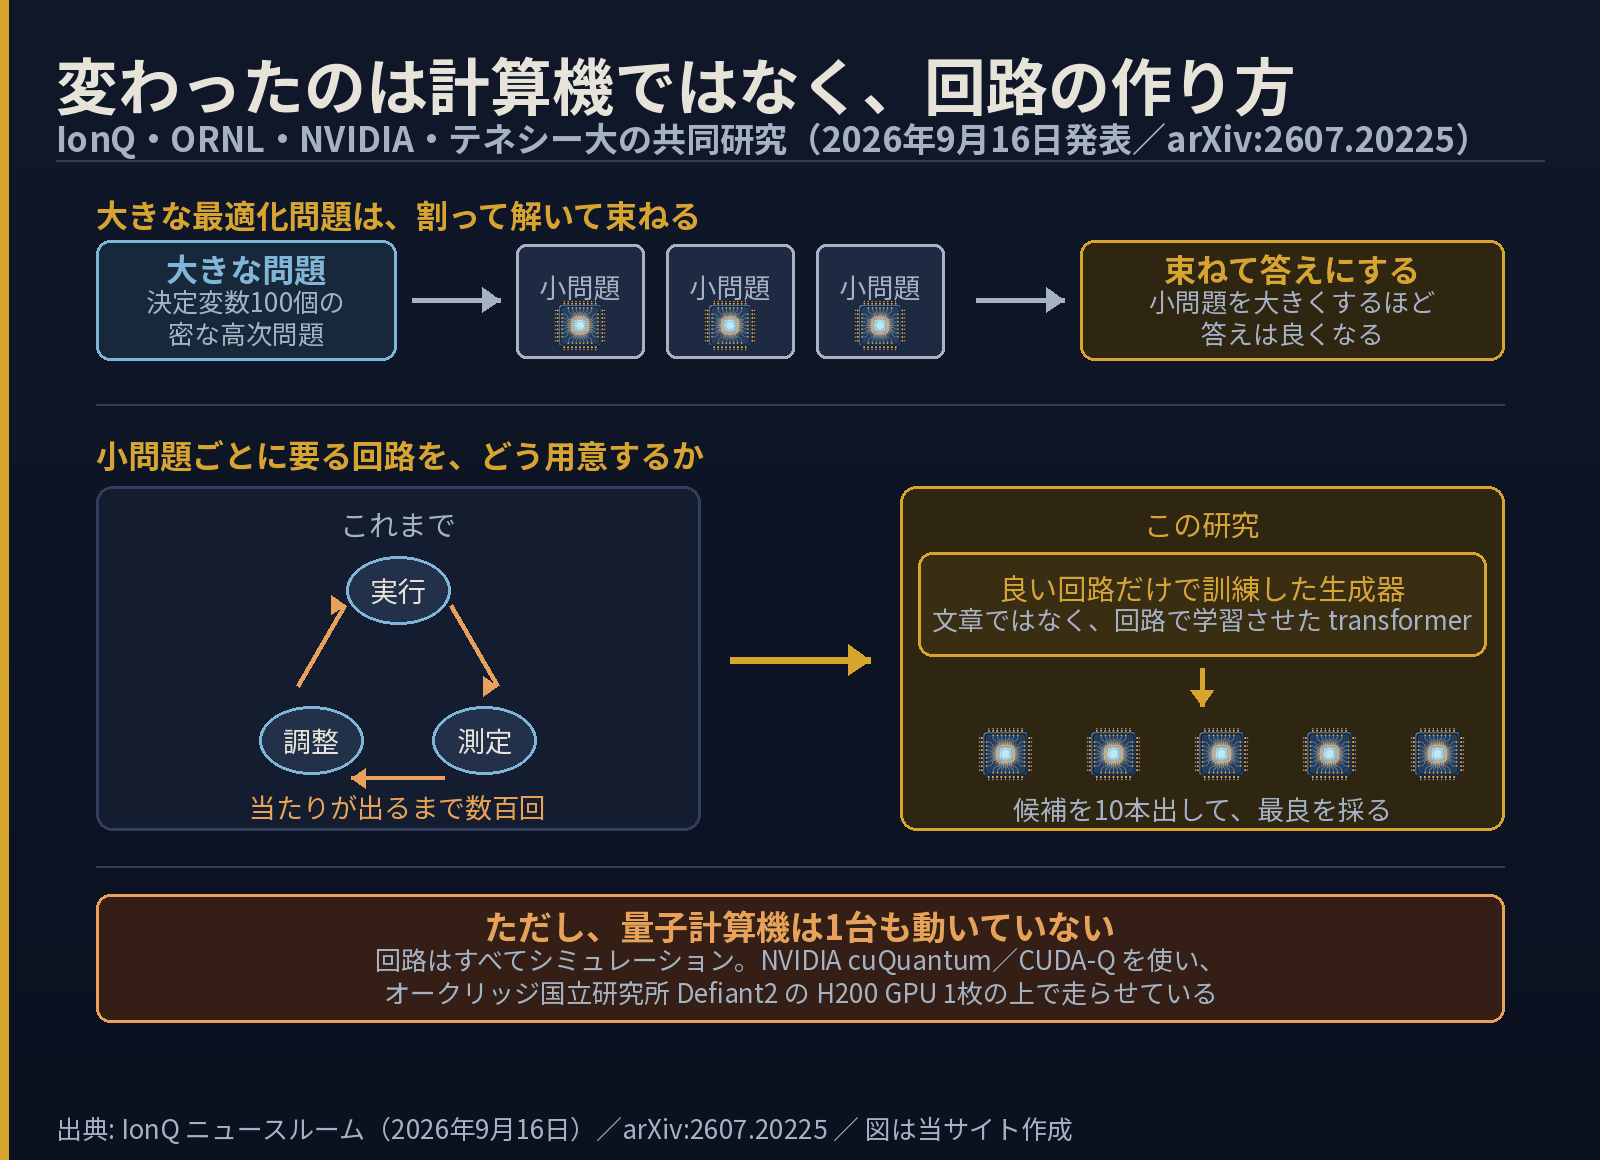
・大きな最適化問題を割って解く方式で、小問題ごとに回路を作り直す必要がある
・これまでは「実行→測定→調整」を数百回繰り返して当たりを探していた
・良い回路だけで訓練した生成器に回路を直接書かせた(候補10本→最良を採用)
・回路探索の時間は 12量子ビットで11分超 → 約28秒。しかも試した全サイズでほぼ一定
・量子計算機は1台も動いていない。すべて GPU 1枚の上のシミュレーション
・IEEE Quantum Week 2026 で最優秀論文賞。IonQ が同会議に通した9本のうちの1本
大きな問題は、割って解いて束ねる
組合せ最適化は、選択肢の数が変数の増加に対して指数的に膨らみます。そこで大きな問題を小さく割り、ひとつずつ解いて、結果を束ね直す。分散型の量子近似最適化(DQAOA)と呼ばれる進め方です。
この方式には、あまり表に出ない面倒があります。小問題ごとに、その問題に合わせた回路を用意しなければならないことです。回路には調整つまみ(変分パラメータ)が付いていて、良い答えが出る位置を探す必要があります。探し方は原始的で、実行して、測って、少しずらして、また実行する。当たりが出るまで数百回まわします。
小問題を大きくすれば答えの質は上がります。ところが大きくするほど、つまみを合わせる手間も膨らむ。質を取れば時間が消え、時間を取れば質が落ちる。解ける問題の大きさは、量子ビットの数ではなくこの往復で頭打ちになっていました。
 ソラ
 インキー
つまみを回すのをやめて、回路を書かせた
研究チームが選んだ道は、ループを速くすることではありません。ループごと外しました。
まず従来のやり方を大量の問題に対して回し、良い結果になった回路だけを残します。その回路を教材にして transformer を訓練する。大規模言語モデルと同じ種類のモデルを、文章ではなく回路で学習させたわけです。訓練を終えたモデルは、小問題を見せられると調整の繰り返しなしに回路を書き出します。
実験では小問題ごとに候補を10本生成し、10本とも評価して最良の1本を採用しました。手法の名前は DQAOA-GPT。
時間の形が変わった
ベンチマークは決定変数100個の密な高次問題です。数字は次のようになりました。
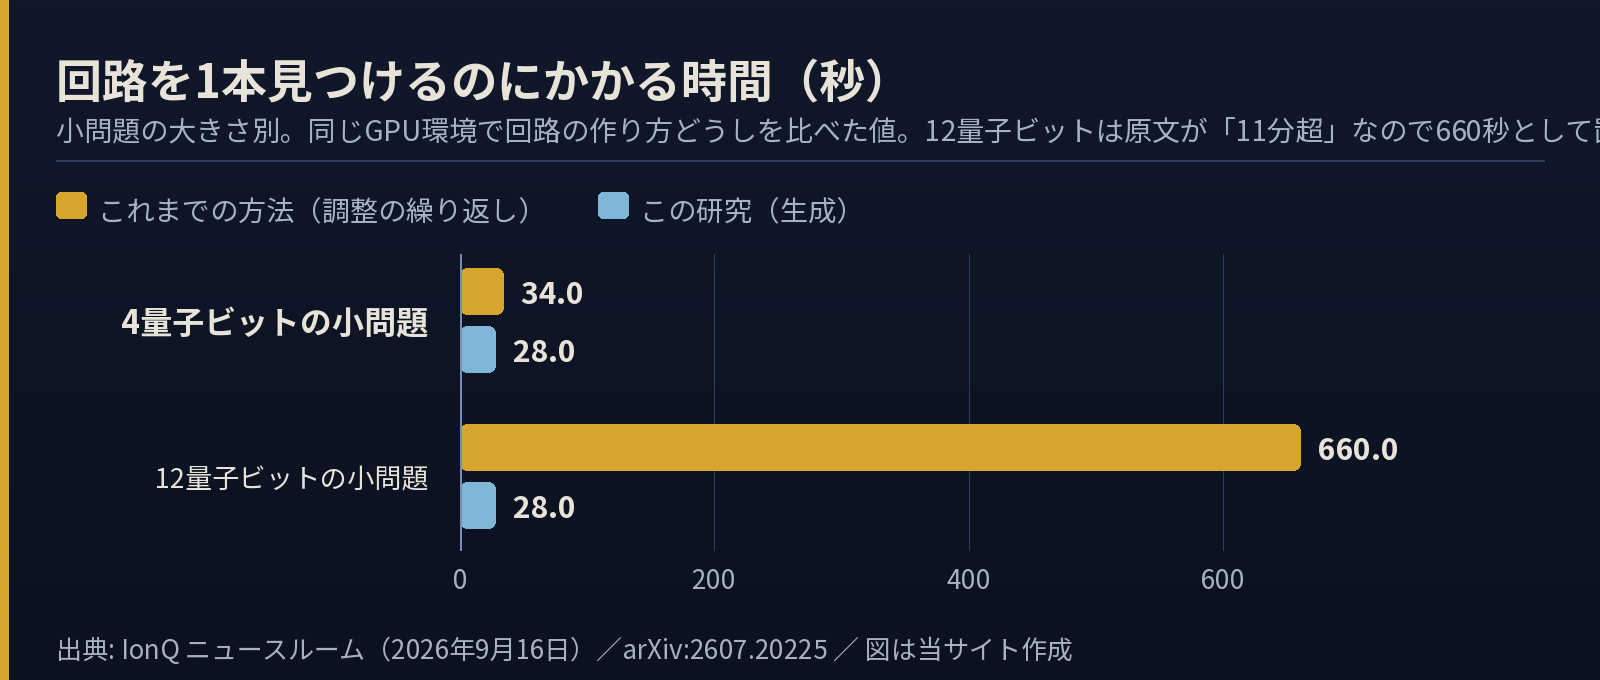
注目すべきは倍率ではなく形です。従来手法は4量子ビットの34秒から12量子ビットの11分超へ、急な坂を登ります。生成方式は試したどのサイズでも約28秒で、坂になりません。小問題を大きくしても時間が増えないなら、大きくしない理由が消えます。そして小問題を大きくすると、生成方式の答えの質はおおよそ2倍に改善しました。
「質を取れば時間が消える」という取引そのものが、ここで崩れています。
量子計算機は、1台も動いていない
ここは強調しておきます。この実験で量子ハードウェアは使われていません。回路はすべてシミュレーションで、NVIDIA の cuQuantum SDK を CUDA-Q 経由で使い、ORNL の Defiant2 システムにある H200 GPU 1枚の上で走らせています。
これは弱点であると同時に、比較を成り立たせている条件でもあります。従来手法と生成方式がまったく同じGPU環境で走ったからこそ、差が回路の作り方の差だと言えます。実機を混ぜると、装置の待ち行列や個体差が数字に入ってしまいます。
もうひとつ、発表文が自分で釘を刺している点があります。どちらも量子手法であり、量子と古典のソルバーを比べたものではありません。「量子が古典に勝った」という話ではないということです。発表文はこの結果を benchmark-scale validation、つまりベンチマーク規模での検証だと書いています。
ソラインキーこの先どうなりそうか
ここからは当サイトの読みです。量子の進み方を測る物差しが、1本増えます。
これまで各社の現在地は、量子ビットの数と誤り率で語られてきました。IonQ の Investor Day で並んだ発表が製造・受注・見通しの話だったように、装置の側の指標です。ところが装置が同じでも、回路の用意にかかる時間が桁で動けば、扱える問題の大きさは変わります。ハードの進歩とは別の軸で、使える範囲が広がる余地があるということです。
方式の違いにも効きます。イオントラップのように接続の自由度が高い装置と、超伝導のように隣としかつながらない装置では、同じ問題でも良い回路の形が違います。回路を生成するモデルは訓練データの出どころに引きずられるので、装置ごとに別のモデルが要るはずです。ここは各社の囲い込みが起きやすい場所です。
NVIDIA の量子製品ディレクターは、AIを最初から組み込んだ量子アルゴリズムを開発者が作れるようにすることが CUDA-Q の狙いだと述べています。量子計算の周りにGPUの層が一枚敷かれるという見立てで、GPUを持つ側から見れば量子は新しい需要先です。この構図は量子4社の売上の中身にも効いてきます。装置を売る会社と、装置を使う道具を売る会社では、伸びる行が違うためです。
どこまで確かめられて、どこからが約束か
| いま確かめられる現在地 | 研究チームが置いている先 | 答え合わせの時期 |
|---|---|---|
| GPU上で回路探索が約28秒でほぼ一定 | 実機での再現 | 実行結果の報告が出るか |
| 決定変数100個・12量子ビットまでの検証 | より大きなHPCへの拡張 | 変数と量子ビットの規模が伸びるか |
| ベンチマーク問題での比較 | 実世界の科学・工学の課題へ適用 | 題材が固有名詞で出るか |
検証できるのは左の列だけです。判断を早める材料を3つ挙げます。ひとつ、同じ手法をシミュレーションではなく実機で回した結果が出るかどうか。ふたつ、生成モデルが訓練に使った装置と別の装置でも通用するかどうか。みっつ、扱う変数が100個から桁で増えるかどうか。100個は小さくはありませんが、産業の現場で出てくる規模にはまだ距離があります。
よくある疑問
いいえ。実験はすべてシミュレーションで、量子ハードウェアは使われていません。発表文自身がベンチマーク規模の検証だと書いています。
違います。比べているのは量子回路の作り方どうしです。発表文にも「量子と古典のソルバーを比べたものではない」と明記されています。
研究を主導したのは ORNL です。IonQ からは Martin Roetteler が共著者として参加しています。著者はORNL・IonQ・NVIDIA・テネシー大にまたがります。
従来手法が見つけた良い回路を教材にしているためです。探索の答えを覚えさせて、探索そのものを省いている形になります。
読みどころ
量子の話題は装置の大きさに寄ります。何量子ビットか、誤り率はいくつか。今回動いたのはそこではなく、装置に問題を渡す前の準備でした。準備が数百回の試行から一発の生成に変わるなら、同じ装置でも入る問題の大きさが変わります。
坂が平らになった、という一点だけを持ち帰れば十分です。ここまではGPUの中の話です。
この記事が数字を取った時点: 2026-09-16(記事はこれより新しい発表も扱います。日付は本文に書いています)
- IonQの発表「ORNL・NVIDIA・テネシー大との共同研究」https://ionq.com/news/ionq-ornl-nvidia-and-the-university-of-tennessee-knoxville-show-ai-method-reduces-quantum-optimization-trade-off
- arXiv 論文「DQAOA-GPT」(2607.20225)https://arxiv.org/abs/2607.20225
数値は上記の原文から取っています。当サイトは特定銘柄の推奨・目標株価・売買の判断を書きません。

コメント